大模型应用开发(一)
内容介绍
本章主要是总结大模型的一些概念,分为四类
- 指令交互类:Prompt, System Prompt
- 模型认知类:Token,上下文窗口,大模型幻觉
- 模型增强类:Structrued Output,Fuction Calling,RAG,Embedding,向量数据库,大模型微调
- 模型自主类:Agent,MCP,Skill
指令交互类——Prompt Engineering
Prompt: 输入给大模型的内容
System Prompt: 给模型指定的行为规则,如扮演什么角色,用什么语气回答,遵守哪些规则,哪些事情不能做,回答时偏向什么风格
大模型能力边界认知
Token: 模型处理的文本的最小单位。输入和输出的内容都会被拆解为它。
上下文窗口: 当前这次对话里,模型临时能看到多少内容。
大模型幻觉: 编造不存在的东西。问它一个不存在的人,它能给你编出完整的履历;问它某个 API 的用法,它能编一个根本不存在的参数。幻觉不是 Bug,是大模型工作方式的"副产物"——它本质上是在预测"下一个最可能出现的 Token",而不是在"检索事实"。
模型增强类
Structrued Output: 格式化输出.用Json类型来约束模型的输出
Fuction Calling: 让模型去调用工具,而不是自己编写
RAG: 检索增强生成。大模型自己不一定知道最新、私有、专业的知识,而且容易“凭感觉编”。RAG 通过外部检索,把模型回答限制在更可靠的资料范围内。离线生成数据库,在线检索,比模型微调成本小。
Embedding: 把文本翻译为一组向量,语义越相近的文本,向量距离越近。
向量数据库: 存向量的专用数据库。普通数据库(MySQL、PostgreSQL)擅长精确匹配和范围查询,但向量检索是"找最近的邻居",这是完全不同的查询模式。
大模型微调: 在一个已经训练好的大模型基础上,再用一批特定数据继续训练,让它更适合某个任务、领域或输出风格。
模型自主类
Agent: 普通大模型主要是:用户问一句,它回答一句。Agent 则更进一步:它不仅能回答问题,还能根据目标进行规划、调用工具、执行步骤,并根据结果继续调整行动。
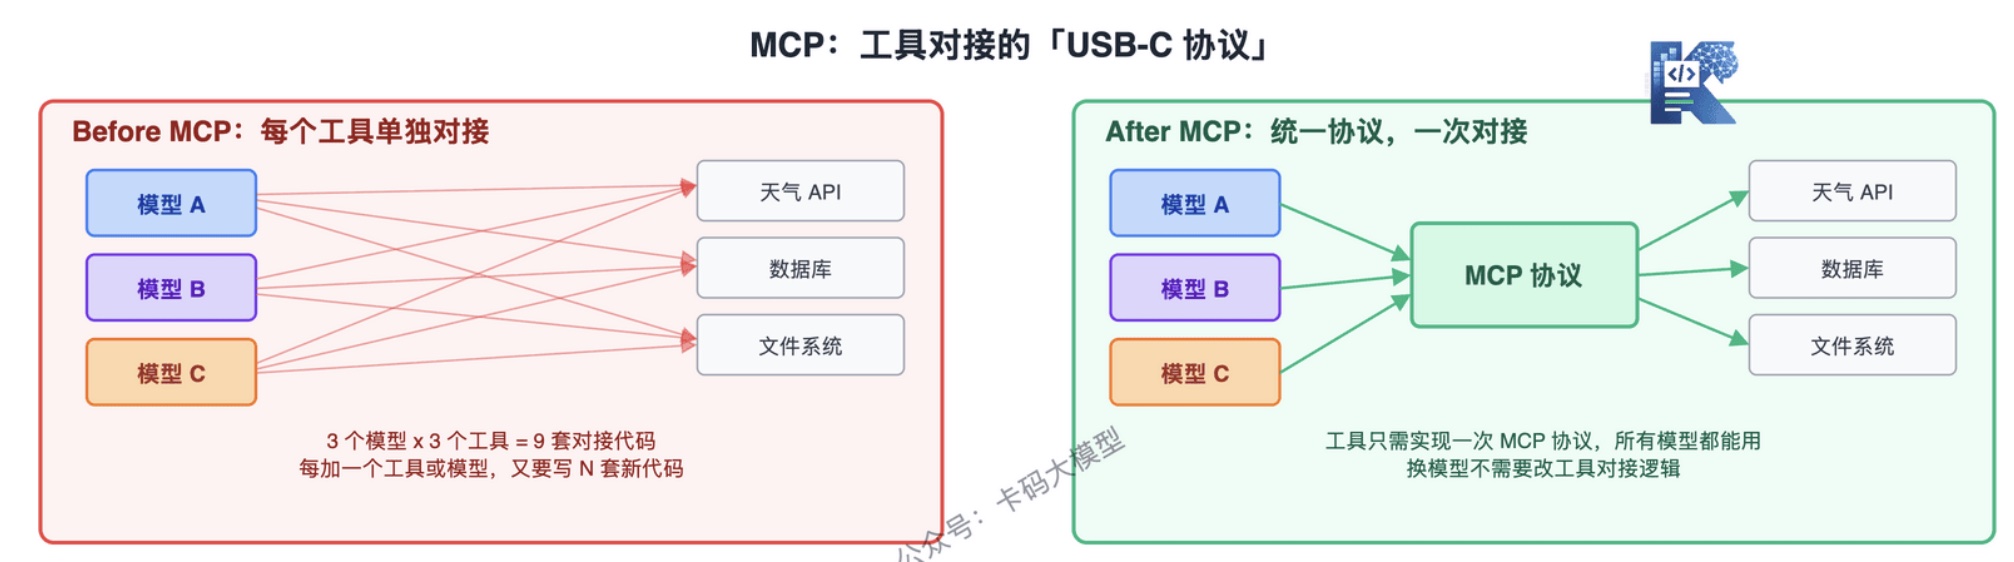
MCP: MCP 是大模型连接外部世界的标准接口,让任何模型都能用统一的方式连接外部工具和数据源。
Skill: Skill 是为 Agent 封装的专项任务能力,用来告诉 Agent 在特定场景下应该如何使用知识、工具和流程来完成任务。可以看作一种更结构化、更可复用的 prompt 持久化。每个 Skill 定义了:能做什么、需要什么输入、输出什么格式、依赖哪些工具。